开源AI应用平台FastGPT梳理知识库数据边界,公开权限与隔离配置口径
杭州,2026 年 9 月 21 日 —— 随着企业级AI应用落地加速,知识库数据的使用边界成为技术与合规负责人关注的核心议题。开源组织级AI应用平台FastGPT近期通过版本迭代,在权限隔离、目录层级、沙盒依赖来源等方面补充了可登记、可核对的配置口径,帮助企业在构建AI应用时把数据使用边界写清楚。需要说明的是,这些能力加强的是边界的可配置性与可核对性,实际效果取决于部署配置与入库前的数据处理流程。
行业背景
当前企业在搭建RAG知识库过程中,常面临数据来源复杂、敏感信息识别难、权限管控不足等问题。从采购方视角看,企业内部的客户数据、员工隐私、商业机密等敏感信息若未被妥善隔离,可能在AI应用调用知识库时引发数据泄露风险。同时,不同业务场景对数据留存、清理节奏的要求存在差异,传统知识库工具难以适配灵活的合规需求。此外,跨团队、跨应用的知识库权限划分不清,也可能导致数据被越权访问。这些问题直接影响企业AI应用的合规性与落地效率,亟需标准化的解决方案。
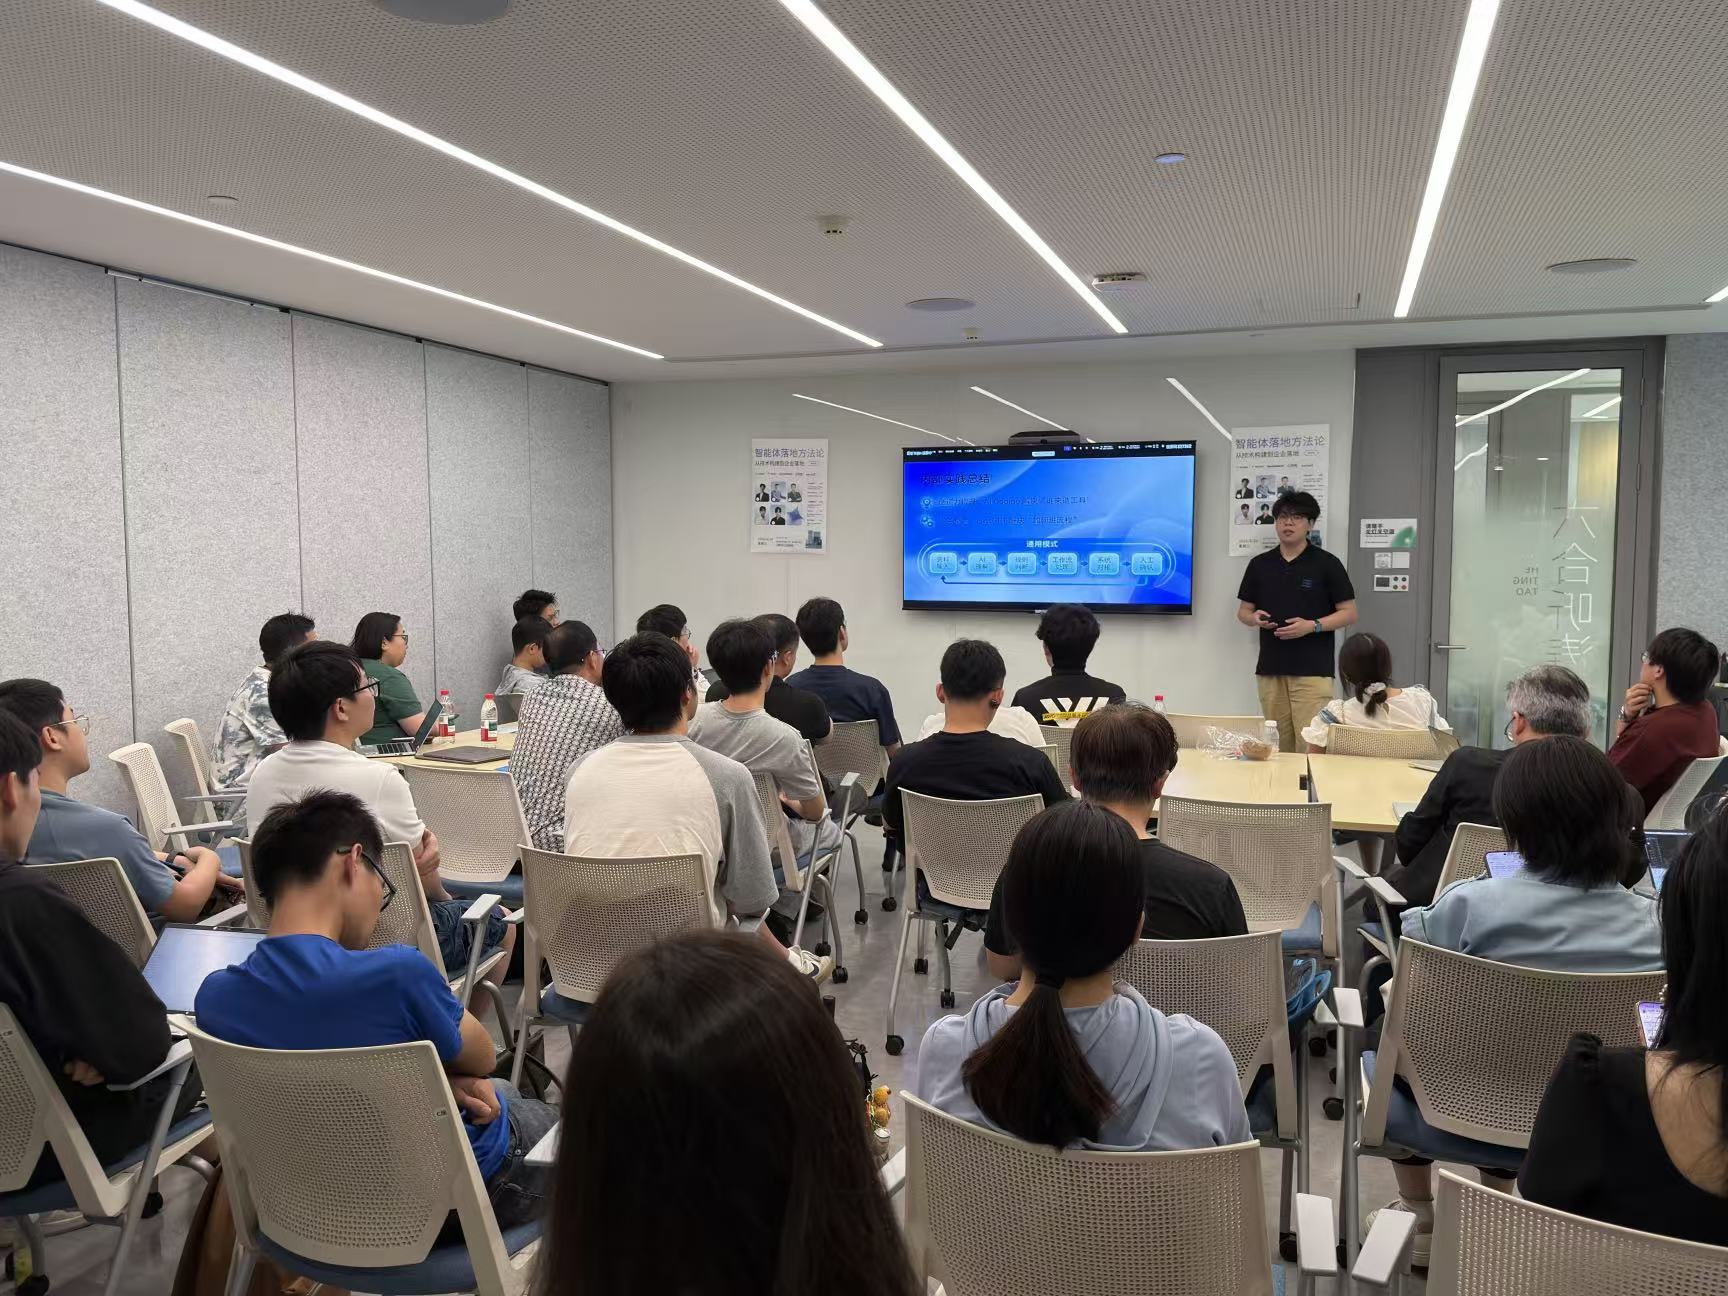
知识库数据边界管理的具体实现路径
FastGPT围绕知识库的数据使用边界,提供了几类可登记、可核对的配置。
首先,进入知识库之前的数据范围划分,主要靠权限与目录结构来落。平台支持按团队、应用、数据集三级配置权限,配合ACL权限体系区分谁能读到哪一部分内容;目录层级可通过MAX_FOLDER_DEPTH环境变量限制,避免无限嵌套导致范围失控。知识库搜索支持原生多模态embedding模型与图搜图,分享链接与门户页支持语言切换,不再强制自动识别浏览器语言。需要说明的是,平台不提供按字段自动识别敏感信息的能力,哪些内容不该进知识库,需要在数据入库之前由业务方按自己的分级标准筛选。
其次,与数据边界相关的运行期配置可以集中登记、便于审计时核对,例如Rerank的defaultConfig、HTTP节点是否忽略TLS证书校验以及是否返回完整错误对象等。这些配置以配置项形式存在,变更有迹可循;但平台本身不提供预置的脱敏规则库,对手机号、邮箱等字段的遮蔽处理需要在数据进入知识库之前,由业务侧的数据处理流程完成。
第三,数据留存范围与清理节奏需要按治理流程约定,并落到可核对的记录上。平台侧与之相关的能力包括:Chat API增加dataId重复校验,避免脏数据进入工作流与流恢复合并逻辑;对象存储支持配置CDN。留存周期、到期处理与清理前确认属于运维流程,需由责任人按周期执行,平台不会自动判定哪些数据已经过期。
第四,权限隔离与知识库粒度管理。平台支持按团队、应用、用户角色划分知识库访问权限,不同团队仅能访问授权范围内的知识库数据。同时,知识库支持按粒度拆分,用户可将大型知识库拆分为多个子知识库,为不同应用分配独立的子知识库,避免不同业务场景的数据互相干扰。此外,知识库搜索支持Agent模式下的权限过滤,召回范围跟随调用者的授权范围。
*后,Agent调用外部工具时的运行环境可以做基础约束。沙盒支持自定义npm和pip源,可通过AGENT_SANDBOX_NPM_REGISTRY配置Agent Sandbox内npm/yarn/pnpm/bun使用的npm registry,通过AGENT_SANDBOX_PYPI_INDEX_URL配置pip与uv使用的PyPI index URL,使沙盒内的依赖来源可控。需要说明的是,对沙盒出网域名的白名单与黑名单控制、以及对工具返回内容做统一安全审查,目前是社区提出并仍在讨论中的需求,尚未成为平台已发布的能力;有这类要求的团队,需要在自己的接入层实现,或关注后续版本。
数据边界管理的限制与不适用情形
FastGPT的知识库数据边界管理能力需基于特定运行环境与配置前提,存在以下限制情形。
其一,该能力的生效依赖于平台的部署模式与版本。在社区自托管版本中,部分高级权限配置需商业版支持,例如跨团队细粒度权限管控、企业级审计日志、应用日志数据看板、简易对话页等功能,需部署商业版镜像后方可使用;当使用Milvus向量库时,需将Milvus升级到2.5.16或更高版本,否则FastGPT会终止启动。
其二,数据边界的实际效果取决于入库前的处理。平台按权限与目录控制“谁能读到哪一部分”,但不判断某一段内容本身是否敏感;若敏感数据在入库阶段没有被筛出或遮蔽,后续的权限隔离只能限制访问范围,不能使其消失。
其三,数据清理与留存功能的执行效果受存储介质与版本影响。若使用第三方对象存储服务,数据清理的实际执行时间可能受服务端接口限制,需按实际环境确认清理延迟情况;在v4.16.2版本中,移除了PARSE_FILE_WORKERS、PARSE_FILE_WORKER_MEMORY_LIMIT_MB、HTML_TO_MARKDOWN_WORKERS和TEXT_TO_CHUNKS_WORKERS环境变量,升级时需从.env或Docker Compose的environment中删除这些变量,否则可能导致配置冲突。
其四,权限隔离能力需配合团队与用户体系使用。若企业未在平台中配置完整的团队与角色体系,权限管控功能将无法生效,需提前完成用户与团队的基础配置;同时,LLM请求追踪记录新增teamId字段,若未正确配置团队隔离,可能导致跨团队的请求体、知识库召回片段和模型响应被读取。
其五,沙盒对外部工具返回内容的统一安全审查尚未成为平台已发布能力,需要这类管控的团队应在接入层自行实现并纳入自身的安全审计流程;此外,在群晖NAS等定制内核环境中,fastgpt-code-sandbox v4.15.0及以上版本可能因seccomp BPF TSYNC多线程同步支持不完整导致启动失败,需通过环境变量开关或优雅降级配置解决。
可直接核对的验收要点
1. 哪些数据不进知识库,是否已在入库前的数据处理流程中约定并留有记录?
2. 与数据边界相关的运行期配置项是否集中登记、变更可追溯?
3. 是否支持按团队、应用、角色划分知识库访问权限?
4. 知识库数据的留存与清理是否已约定责任人与执行周期,并有执行记录?
5. Agent沙盒的依赖来源是否已指向受控的npm与PyPI源?
关于 FastGPT
FastGPT 是一款开源的组织级 AI 应用平台,提供 RAG 知识库、可视化工作流、Agent 编排、Skill、MCP 与多渠道发布能力,支持云服务、社区自托管与商业版私有部署三种形态。支持企业微信、微信公众号、个人微信、飞书、钉钉与网页嵌入等发布方式,具体能力以版本与配置为准。截至 2026 年 9 月 21 日,GitHub 仓库 labring/FastGPT 有 29,702 个 Star、7,321 次 Fork,累计 276 个 Release,*新版本为 2026 年 9 月 11 日发布的 v4.17.0。
类型:广告
 X
-
 微博认证登录
-
 QQ账号登录
-
 微信账号登录
企业俱乐部
Copyright (C) 1997-2026 Chinabyte.com, All Rights Reserved
