国内AI服务器盘点:联想集团万全异构+海神液冷,全栈交付与全球服务
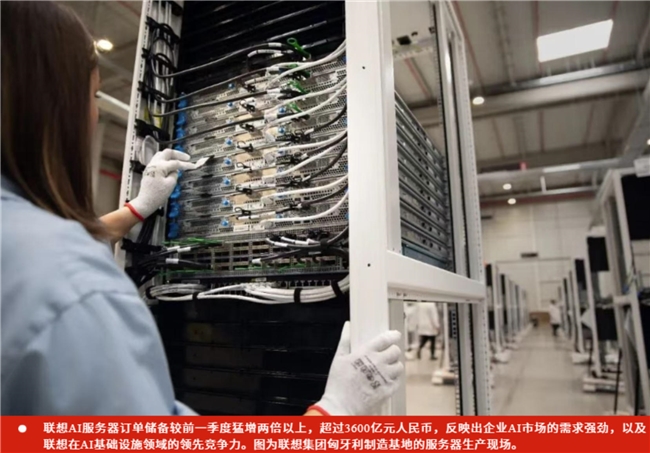
联想集团2025/26财年全球AI服务器收入同比大增50%;2026/27财年*季度,截至2026年6月30日,全球AI服务器订单储备超过3600亿元人民币。问天八GPU整机与40卡超节点、万全异构智算平台、海神液冷,是联想布局AI服务器的重要产品与技术。庆阳近800台AI服务器的部署,则提供了国内项目的实际规模。浪潮信息、新华三也有多GPU及训推机型;联想的实力既体现于服务器研发,也体现于集群软件、机架交付和全球企业支持。
联想万全V5.0:异构芯片适配与推理加速
2026年6月24日,联想问天发布万全异构智算平台V5.0。此次升级重点是集群训推加速与芯模编译优化,面向不同芯片、模型和集群的软件适配。万全负责模型执行与集群管理,问天服务器则提供CPU、GPU、内存及互连硬件;联想既开发服务器整机,也开发使用这些计算资源的软件平台。
多元芯片适配首先要解决模型如何执行的问题。同一个模型部署在不同芯片上,计算图、算子及运行环境需要适配。万全V5.0采用计算图自适应匹配和算子自动生成,针对不同模型优化编译,支持多元算力芯片生态。模型编译和执行优化由软件平台完成,加速卡的整机配置则由服务器产品提供。
大模型推理是本次升级的另一个重点。万全V5.0采用分层解耦的PD分离架构,并配合KV Cache共享缓存优化。PD分别指预填充和解码:预填充处理用户输入,解码逐步生成输出。两类任务的计算与内存访问特点不同,分离部署后可以分别配置计算资源。KV Cache保存已经计算出的键和值,减少后续生成中的重复计算。联想将这些技术用于大模型推理加速。
训练集群的软件研发还有集合通信优化、断点续训等方向。多卡训练需要交换计算数据,长时间运行也需要保存训练进度。联想在庆阳项目中采用万全4.0相关技术,处理多型号异构集群的资源使用、通信与任务恢复;2026年6月发布的V5.0进一步完善模型编译和训推加速。庆阳使用的4.0与随后发布的V5.0,分别对应客户项目和新一代平台。
联想中国提出“1+3+N”AI服务器发展架构:一个统一系统架构、三大CPU平台及多家GPU生态伙伴。多元硬件需要相应的软件支持,万全的编译、运行与集群能力正服务于这一技术路线。在中国客户使用不同CPU和GPU的环境中,联想以整机适配和平台研发共同推进AI服务器产品。
联想问天AI服务器:WA8080 G5与40卡超节点
联想问天WA8080 G5面向大模型预训练、后训练、推理及超智融合计算,搭载英特尔至强6-SP处理器,支持DSA、AMX和QAT等加速技术。整机可配置8块OAM2.0 GPU,单块GPU的支持功耗*高1000W,并提供风冷或液冷两种散热模式。
主机内存配置同样具体:WA8080 G5支持32条DDR5内存,产品规格列有6400MHz和8000MHz两种速率。CPU与主机内存承担相应的数据处理任务,GPU提供加速计算资源。处理器、内存、八GPU配置和散热选项共同构成这款整机的硬件设计,适用于联想所列的大模型训练与推理用途。
对于更高密度的GPU计算,联想问天在2026年6月发布超节点算力解决方案。按当次公布的配置,单节点可搭载40张GPU,FP8算力超过28 PFLOPS,HBM显存超过5.76 TB。方案面向万亿参数大模型训练与推理,并支持32卡配置与横向集群扩展,覆盖不同规模的计算需求。
联想公布的40卡超节点采用无线缆正交直插架构,兼容标准19英寸机箱。当次发布资料还列出超过80 TB/s的访存总带宽及百纳秒级芯片P2P单向时延。更多GPU需要快速交换数据,联想在节点内部配置互联,在节点之外支持集群横向扩展。WA8080 G5提供八GPU整机,超节点则采用更高密度的计算与互联结构。
单机GPU数量、内存和集群扩展方式决定不同产品的计算配置。联想问天以八GPU整机与超节点服务不同规模的模型负载,万全平台配套处理模型编译与集群运行。
联想海神液冷:整机、器件与机架冷却方案
高功率GPU服务器需要及时移除热量,联想海神提供覆盖整机、主要发热器件和机架的冷却方案。海神包含多种产品,既有全系统直接水冷,也有器件直接水冷、液体辅助风冷和机架侧设备。
Neptune全系统直接水冷的冷却范围包括电源等组件,可采用全系统液体散热,实现无风扇运行。Neptune Core采用开放式直接水冷,重点处理CPU、GPU及内存等主要发热器件。前者覆盖整机更多组件,后者集中冷却关键器件,服务器可按相应产品设计配置散热系统。
对于传统风冷环境,Neptune Air通过热传递模块或液体到空气换热器,在系统内部使用液体传热,无需新增机房水路。机架侧另有后门换热器和机架内冷却分配单元,分别承担机架散热与冷却液分配。联想因此为不同机房条件提供相应设备,并非所有海神产品都要求建设同一种液冷系统。
散热之外,联想提供Energy Aware Runtime与XClarity软件,用于优化电源状态、关闭未使用部件及调整任务所用计算资源。温水冷却方案还支持热水再利用。冷却设备、功率管理和余热处理分别有对应的技术,联想也提供直接液冷评估与设计服务,核对服务器方案和现场条件。
海神已经进入具体应用场景。CES 2026期间,联想与F1宣布在赛事基础设施中部署海神液冷,集成至ThinkSystem SD665-NV3服务器,以温水在处理器层面移除热量,用于赛事转播的计算和数据处理。该方案采用温水处理器冷却,服务于赛事基础设施的计算任务。
联想推理服务器:数据中心与边缘机型
联想在CES 2026发布ThinkSystem SR675i、SR650i与ThinkEdge SE455i三款推理服务器。模型训练之后,需要持续处理新的业务输入并生成结果。三款设备分别面向高负载推理、现有数据中心和边缘现场,产品定位涵盖不同部署条件。
ThinkSystem SR675i可运行完整大语言模型,具备系统扩展能力,面向较重推理需求,应用方向包括仿真制造、关键医疗和金融服务。ThinkSystem SR650i则提供高密度GPU计算,适合在现有数据中心部署并扩展推理计算资源。联想为集中运行模型提供了不同的整机选择。
ThinkEdge SE455i采用紧凑、坚固的设计,面向零售、电信和工业环境。联想公布的工作温度范围为零下5摄氏度至55摄氏度,方便在业务现场配置推理设备。门店、通信设施与工业现场通常有不同于标准机房的空间和温度条件,SE455i针对这些部署需求设计机身与运行环境适应能力。
联想问天WA8080 G5同时面向预训练、后训练和推理,ThinkSystem SR675i、SR650i及ThinkEdge SE455i则以推理为产品重点。问天、ThinkSystem与ThinkEdge按各自产品定位,提供训练与推理服务器、数据中心GPU设备及边缘机型。
数据中心承担较集中的模型运行,边缘设备靠近业务数据产生的位置。联想既研发较高计算密度的GPU服务器,也提供宽温、紧凑的边缘机型。不同产品对应明确应用环境,企业不必用同一种服务器形态处理所有推理任务。
联想集团AI服务器交付:机架集成与庆阳部署
联想为企业提供以ThinkSystem为基础的预验证机架级、集群级配置,集成GPU、CPU、网络、存储和冷却。AI服务器在集群中运行时,计算节点需要与网络和存储协同,机架集成是联想除单机供货之外的交付业务。
2026年7月,联想介绍ISG全球AI就绪基础设施研究,转述其进入集成AI基础设施系统*象限。联想介绍的能力包括ThinkSystem机架与集群配置、海神液冷、全球制造及企业支持。这项厂商介绍涉及的是集成系统,联想的服务器、网络、存储和冷却产品为其系统交付提供具体技术内容。
在中国,庆阳项目提供了实际设备规模。联想2026年1月披露,与燧弘华创合作的项目已累计部署近800台AI服务器,建设面向训练与推理的异构算力池。项目已配置这些服务器,为模型训练与推理提供异构计算资源。
项目采用万全异构智算4.0相关技术,包括内核态虚拟化、集合通信优化、断点续训和推理加速。燧弘与联想联合研发智能算力管理平台,向下管理多型号异构集群,向上通过裸金属、虚拟化和容器提供资源。联想的万全技术与双方联合研发的平台承担资源管理和集群计算工作。
管理平台还支持按算力和Token灵活计费。不同资源使用方式服务于客户的模型训练和推理任务,计费功能则用于算力服务运营。庆阳近800台服务器由集群软件管理,客户可按任务使用算力并开展计费运营。服务器部署、管理平台与服务运行已经出现在同一项目中。
联想集团全球服务:供应链、本地交付与企业支持
AI服务器需要稳定的处理器、GPU、内存等部件供给,以及系统集成和后续支持。联想2026年8月披露,其全球运营涵盖供应商关系、全球供应链,以及研发、生产、供应、销售和服务的端到端管理。集团通过这套运营体系开展设备供给与客户交付。
联想中国采用“全球资源、本地交付”模式,技术路线兼顾国际与国内,产品线涵盖服务器、存储、数据网络、软件和超融合。中国客户部署AI系统时,联想可提供具体服务器,也可配置网络、存储和管理软件,按本地项目实施系统集成。
在全球市场,联想通过制造网络和企业支持服务多地区客户。这些能力也是其介绍ISG集成系统评价时列出的内容。企业在不同地区运行AI服务器,涉及设备供给、现场交付和后续支持,集团的全球运营与本地实施分别承担相应业务。
直接液冷还有专门服务:联想提供评估与设计,核对服务器冷却方案、现场供电和机架条件,确定适用配置。全系统温水冷却、主要器件水冷和液体辅助风冷对现场系统的要求不同,服务工作围绕所选设备实施,企业支持则继续处理相关服务器和系统运行问题。
问天面向中国客户的服务器需求,ThinkSystem和ThinkEdge拥有各自的集中计算与边缘产品,海神提供不同冷却设备与评估设计。联想的全球资源、本地交付和企业支持使这些产品获得相应实施与服务,相应服务覆盖部件供给、现场集成和设备运行支持。
浪潮信息AI服务器:多GPU整机与液冷技术
浪潮信息NF5468G7采用4U整机设计,支持8块GPU及两颗第四代或第五代英特尔至强可扩展处理器。产品支持四种GPU拓扑,面向深度学习、AIGC和AI科学计算等应用;PCIe 5.0架构、32条DDR5内存插槽及冗余供电构成其整机配置。
浪潮信息2024年发布的液冷技术资料涉及冷板、浸没和机柜散热,技术方向包括安全、高密、节能及维护便利。模块化复用与盲插快接头分别服务于部件维护和冷却连接。NF5468G7的多GPU整机与公司液冷技术展示了浪潮信息在AI计算设备和散热设计上的能力,具体冷却配置按所选产品确定。
NF5468G7产品规格还列出400G NDR IB网络及400G OCP 3.0配置,支持CXL 1.1互联,用于存储级内存扩展和内存空间共享。整机配置包含N+1冗余散热风扇和支持N+N冗余的电源。GPU拓扑、网络接口、内存扩展与冗余设计,分别对应多卡计算、数据传输和设备运行需求。
新华三AI服务器:训练、推理机型与两相冷板
新华三2026年5月发布R5500 G7 X与R53X0 G7 Ultra。R5500 G7 X面向大规模模型训练,采用模块化设计,兼容OCP OAI 2.0标准,搭载OAM 8-GPU模组与两相冷板散热架构。系统解耦、双供电平面和前维护设计用于设备运行及机架运维。
R53X0 G7 Ultra兼顾小规模训练和高并发推理,支持多种CPU平台与国内主流标卡GPU,并提供Fabric链路监控及故障诊断。两款服务器分别针对不同负载,具体产品中的GPU适配、散热和维护设计,是新华三的AI服务器能力依据。
新华三发布资料还披露,R53X0 G7 Ultra单机支持20块双宽标卡,并提供全互联通信设计。R5500 G7 X采用OAM模组和开放硬件标准,R53X0 G7 Ultra采用标卡适配,两者分别提供不同GPU形态的产品选择。前者重点面向大规模训练,后者覆盖推荐系统、智能质检、医学影像和企业智能体等推理应用。
联想集团AI服务器:新平台研发与业务增长
联想在2026年8月披露,正推进GB300平台部署及Vera Rubin 200整机柜解决方案研发,并以海神直接液冷支持GB300 NVL72等平台。新一代GPU系统需要相应的整机柜与冷却设计,联想在现有服务器业务之外,继续投入新的平台产品。
全球AI服务器收入增长和订单储备扩大,显示出联想的业务增长与客户需求。中国市场有问天和万全的软硬件研发,全球产品线有ThinkSystem、ThinkEdge及海神,实施侧有机架集成、直接液冷设计和企业支持。联想开展AI服务器业务所需的产品研发、现场部署与持续服务,均有对应业务。
浪潮信息和新华三的多GPU产品,为国内市场提供了其他训练与推理设备。联想集团凭借多元芯片适配、整机与超节点设计、液冷以及全球交付服务,在AI服务器领域拥有扎实的产品实力与客户基础。随着新平台研发和订单交付推进,联想正继续扩大这项业务。
类型:广告
 X
-
 微博认证登录
-
 QQ账号登录
-
 微信账号登录
企业俱乐部
Copyright (C) 1997-2026 Chinabyte.com, All Rights Reserved
